作者: 引线小白-本文永久链接:https://www.limoncc.com/post/459cffa89d9d94ff/
知识共享许可协议: 本博客采用署名-非商业-禁止演绎4.0国际许可证
1. 引言
在大模型架构设计中,归一化层看似不起眼,却直接影响训练的稳定性、收敛速度与最终模型质量。自 Transformer 诞生起,层归一化(LayerNorm) 一直是标准配置。然而,从 LLaMA 开始,RMSNorm 逐步取代 LayerNorm 成为事实上的行业标准。其核心理念来自张量与 Sennrich 的开创性工作《Root Mean Square Layer Normalization》,系统论证了“减均值”步骤的冗余性,并提出仅依赖重缩放便能实现同等甚至更优的性能。
核心思想:$\displaystyle y = \frac{x}{RMS(x)} * γ$,舍弃 $\displaystyle x - \mu$,只用均方根做归一化。
为什么这样“偷工减料”反而更好?下面我们从定义开始,逐层深入其背后的数学与工程智慧。
2. 数学定义对比
对于一个特征维度为 $d$ 的输入向量 $\displaystyle \bm{x}=[x_1,\cdots,x_d]^\T$,LayerNorm 与 RMSNorm 的前向计算对比如下。
$\displaystyle\bm{y}=\frac{\bm{x}-\mu}{\sqrt{\sigma^2+\varepsilon}}*\gamma+\beta$
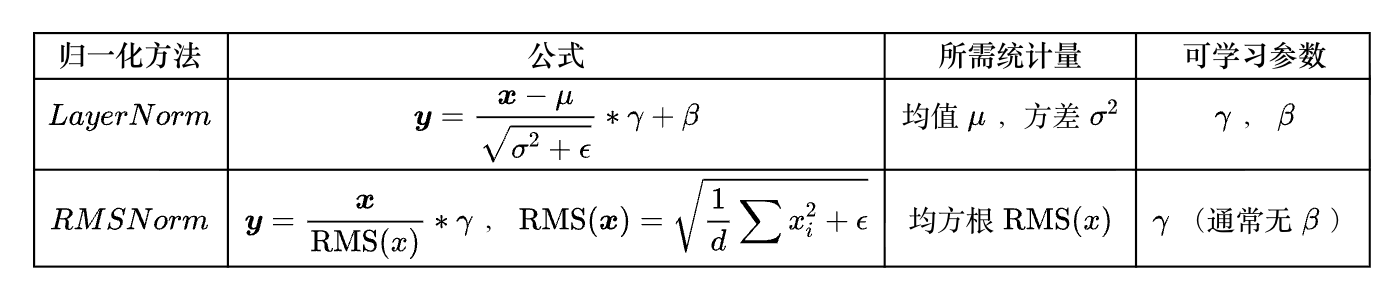
其中 $\gamma$ 和 $\beta$ 为可学习的缩放与平移参数, $\varepsilon$ 为小常数(如 1e-5)用于数值稳定。
可以看到,RMSNorm[^1] 在数学上删减了三个操作:计算均值 $\mu$、广播减法 $\bm{x}-\mu$、以及可选的偏移参数 $\beta$。这些删减看似微小,但在大模型层层堆叠时,累积收益极为可观。
3. 主要优势
3.1 计算效率:训练时间可缩短 7%~64%
减少一次跨维度求和与广播减法,在 GPU 上减少了一次归约(reduce)操作。对于较深的网络,这个开销被逐层放大,实测在多种模型上训练时间可减少 7% 至 64%。注意,在现代 GPU 上,全局均值的计算往往成为内存带宽瓶颈,RMSNorm 省去该步骤后,并行效率更高。
3.2 显存与训练稳定性
LayerNorm 在反向传播时需要保存均值 $\mu$ 作为中间变量,RMSNorm 仅需保存均方根 $\mathrm{RMS}(\bm{x})$ 或平方和,显存占用更小。同时,简化的操作避免了因均值漂移引起的数值不稳定,深层网络训练中梯度范数更平稳。
3.3 “减均值”被证明冗余
理论分析与大量实验表明:在训练过程中,大模型的隐藏表示会自然变得与全 1 向量 $\bm{1}$几乎正交。这等价于均值 $\mu=0$,因此减去均值这一步近乎在减去零,纯属多余。下一节将从几何和梯度视角给出严格解释。
3.4 性能不减反增
虽然删减了一个操作,RMSNorm 学到的隐藏表示分布与 LayerNorm 高度相似,在多项语言建模、翻译等任务中性能持平或略有提升。这也是它能被大模型团队放心采纳的关键。
个人评述:工程上,“快而不差”的组件总能迅速铺开。RMSNorm 不仅更快,而且数学上更干净——这一特性使其成为新一代架构的默认选择。
4. 重缩放不变性与隐式学习率适应
RMSNorm 的深层优势在于它赋予了网络两种优雅的性质:重缩放不变性与隐式学习率适应,二者共同保证了训练过程的鲁棒性。
4.1 重缩放不变性的证明
重缩放不变性是指:若对输入 $\bm{x}$ 或权重矩阵 $\bm{W}$ 乘以一个正常数 $\alpha$,RMSNorm 的归一化输出保持不变。
定理 1(输入缩放不变性) 对于任意 $\alpha > 0$,令 $\bm{x}’ = \alpha \bm{x}$,则
$$\begin{align}
\frac{x’_i}{\text{RMS}(x’)} = \frac{x_i}{\text{RMS}(x)}
\end{align}$$
证明:
$$\begin{align}
\mathrm{RMS}(\alpha\bm{x}) = \sqrt{\frac{1}{d}\sum_i (\alpha x_i)^2} = |\alpha| \,\mathrm{RMS}(x)
\end{align}$$
代入得
$$\begin{align}
\frac{\alpha x_i}{\alpha\,\text{RMS}(x)} = \frac{x_i}{\text{RMS}(x)}
\end{align}$$
同理,对权重矩阵整体缩放 $\bm{W}’=\alpha \bm{W}$ 由于 $\bm{h}’=\alpha \bm{W}\bm{x}$,均方根变为 $\alpha \mathrm{RMS}(\bm{W}\bm{x})$,归一化输出也不变。这一性质使前向传播在参数幅度变化时保持稳定,防止输出范数异常波动。
4.2 隐式学习率适应机制
缩放不变性不仅影响前向,更通过反向传播实现了隐式的学习率自适应。考虑线性层 + RMSNorm 的简单组合:
$$\begin{align}
\bm{h} = \bm{W}\bm{x},\quad \bm{\hat{h}} = \frac{\bm{h}}{\mathrm{RMS}(\bm{h})},\quad \ell = L(\bm{\hat{h}})
\end{align}$$
当权重缩放 $\bm{W}\to \alpha\bm{W}$时,梯度 $\displaystyle \frac{\partial \ell}{\partial \bm{W}}$ 会相应地缩放 $\displaystyle \frac{1}{\alpha}$。具体来说:
$$\begin{align}
\frac{\partial \ell}{\partial (\alpha \bm{W})} = \frac{1}{\alpha}\frac{\partial \ell}{\partial \bm{W}}
\end{align}$$
定义参数的相对更新幅度为 $\frac{|\Delta \bm{W}|}{|\bm{W}|}$,它决定了参数在空间中实际移动的相对距离,这等价于“有效学习率”的作用。
1. SGD 优化器下的分析
在 SGD 更新中,参数更新量为 $\Delta \bm{W} = -\eta \frac{\partial \ell}{\partial \bm{W}}$。若权重缩放 $\alpha$ 倍,更新量变为 $\Delta (\alpha\bm{W}) = -\eta \frac{1}{\alpha}\frac{\partial \ell}{\partial \bm{W}}$。此时相对更新幅度为:
$$
\frac{|\Delta (\alpha\bm{W})|}{|\alpha\bm{W}|} = \frac{1}{\alpha^2} \frac{|\Delta \bm{W}|}{|\bm{W}|}
$$
即有效学习率等比于 $\frac{\eta}{\alpha^2}$。这意味着权重范数的变动会引起有效学习率的平方级变化。
- 权重范数变大 → 有效学习率自动变小,抑制梯度爆炸;
- 权重范数变小 → 有效学习率自动变大,加速逃离平坦区。
2. Adam 优化器下的分析
大模型通常采用 Adam 优化器。Adam 的核心在于引入了梯度的二阶矩(历史梯度平方的指数移动平均)进行逐元素归一化。简记梯度 $\displaystyle \bm{g} = \frac{\partial \ell}{\partial \bm{W}}$,其更新规则为:
$$\begin{align}
\bm{m}_t = \beta_1 \bm{m}_{t-1} + (1-\beta_1)\bm{g}, \quad \bm{v}_t = \beta_2 \bm{v}_{t-1} + (1-\beta_2)\bm{g}^2, \quad \Delta \bm{W} = -\eta \frac{\bm{m}_t}{\sqrt{\bm{v}_t} + \epsilon}
\end{align}$$
当权重缩放 $\bm{W}\to \alpha\bm{W}$ 时,梯度缩放 $\bm{g}\to \frac{1}{\alpha}\bm{g}$。由于一阶矩 $\bm{m}$ 和二阶矩 $\bm{v}$ 均为梯度的线性组合,它们也会相应缩放:$\bm{m}\to \frac{1}{\alpha}\bm{m}$,$\bm{v}\to \frac{1}{\alpha^2}\bm{v}$。
代入 Adam 的更新公式,在 $\sqrt{\bm{v}} \gg \epsilon$ 的正常训练阶段,更新量变为:
$$
\Delta (\alpha\bm{W}) = -\eta \frac{\frac{1}{\alpha}\bm{m}}{\sqrt{\frac{1}{\alpha^2}\bm{v}} + \epsilon} \approx -\eta \frac{\frac{1}{\alpha}\bm{m}}{\frac{1}{\alpha}\sqrt{\bm{v}}} = -\eta \frac{\bm{m}}{\sqrt{\bm{v}}} = \Delta \bm{W}
$$
这意味着 Adam 的更新量 $\Delta \bm{W}$ 对权重的缩放是不变的! 然而,由于分母(参数本身)变大了,其相对更新幅度变为:
$$
\frac{|\Delta (\alpha\bm{W})|}{|\alpha\bm{W}|} = \frac{1}{\alpha} \frac{|\Delta \bm{W}|}{|\bm{W}|}
$$
即 Adam 下的有效学习率等比于 $\displaystyle \frac{\eta}{\alpha}$。
SGD 与 Adam 的对比与意义:
- SGD:有效学习率 $\propto \frac{1}{\alpha^2}$(平方反比),适应过于激进,权重稍大就可能陷入梯度停滞,权重稍小则易引发爆炸。
- Adam:有效学习率 $\propto \frac{1}{\alpha}$(线性反比),Adam 的逐元素梯度归一化(SignSGD 效应)抵消了梯度幅度 $1/\alpha$ 的变化,仅保留了参数尺度 $\alpha$ 带来的相对变化,使得隐式适应更加温和精准。
无论哪种优化器,RMSNorm 都赋予了网络天然的鲁棒性:
- 权重范数变大 → 有效学习率自动变小,抑制梯度爆炸;
- 权重范数变小 → 有效学习率自动变大,加速逃离平坦区。
无需手动调整学习率,训练过程对参数尺度天然鲁棒。这就是 “隐式学习率适应” 的实质。而 Adam 优化器的引入,将这种适应从“剧烈的平方级”平滑到了“温和的线性级”,这是深度神经网络结合 RMSNorm 与 Adam 能够极其稳定训练的底层数学原因。
个人评述:重缩放不变性与隐式学习率适应是一体两面:前向保证输出稳定,反向则动态调整更新幅度。在 Adam 的加持下,这种自适应变得更为平滑,避免了 SGD 下平方级波动带来的训练不稳定。这是 RMSNorm + Adam 组合能够稳定训练超大模型的关键数学支撑。
5. 梯度反向传播的严谨推导
为了看清 RMSNorm 在反向传播中的数值行为,我们给出完整的梯度推导。定义:
$$\begin{align}
r = \text{RMS}(\bm{x}) = \sqrt{\frac{1}{d}\sum_{k=1}^d x_k^2 + \epsilon}
\end{align}$$
另外定义
$$\begin{align}
\hat{x}_i = \frac{x_i}{r},\quad y_i = \hat{x}_i \cdot \gamma_i
\end{align}$$
损失 $\ell$ 对输入 $x_i$ 的梯度由两条路径贡献:直接路径与通过 r 的全局路径。
经过链式法则与合并,最终梯度为:
$$\begin{align}
\frac{\partial \ell}{\partial x_i} = \frac{\gamma_i}{r}\frac{\partial \ell}{\partial y_i} - \frac{x_i}{d \cdot r^2}\sum_{k=1}^d \left(\frac{\partial \ell}{\partial y_k} \cdot \frac{x_k \gamma_k}{r}\right)
\end{align}$$
若记 $\displaystyle \delta_k = \frac{\partial \ell}{\partial y_k}$ 可简写为:
$$\begin{align}
\frac{\partial \ell}{\partial x_i} = \frac{1}{r}\left( \gamma_i \delta_i - \frac{x_i}{d \cdot r}\sum_{k=1}^d \gamma_k x_k \delta_k \right)
\end{align}$$
该公式对称、简洁,且数值稳定。第一项是各维度的直接缩放梯度,第二项则通过均方根 r 引入全局耦合,实现自然的梯度均衡。
个人评述:实现时可以直接复用前向计算中得到的 r 与 x/r,减少重复计算,这也是 RMSNorm 在框架中易于高效实现的原因。
6. 与 LayerNorm 的几何统一性
尽管 RMSNorm 省略了减均值,但近期几何分析(Gupta et al., 2024)揭示了两者之间深刻的统一性。
LayerNorm 的标准化步骤可被几何分解为三步:
- 移除全 $\bm{1}$ 向量方向的分量:计算 $\displaystyle \mu = \frac{1}{d}\bm{1}^\T \bm{x}$,得到 $\bm{x}_\perp = \bm{x}-\mu \bm{1}$ ,即投影到 $\bm{1}$ 的正交补空间。
- 在子空间中归一化至单位球面: $\displaystyle \bm{y}=\frac{\bm{x}_\perp}{\sigma} $,其中 $\displaystyle \sigma^2 = \frac{1}{d}|\bm{x}_\perp|^2$。
- **缩放至半径 $\displaystyle \sqrt{d}:z = \sqrt{d} \bm{y}$ ,使得最终范数保持为 $ \sqrt{d}$。
而 RMSNorm 则是直接将原始向量 $\bm{x}$ 沿径向缩放到半径为 $ \sqrt{d}$ 的超球面上:
$$\begin{align}
\hat{x} = \sqrt{d} \cdot \frac{x}{|x|}
\end{align}$$
两者之差仅在于是否先执行“沿 \bm{1} 方向的正交投影”这一步。数学上可以写为:
$$\begin{align}
\mathrm{LayerNorm}(\bm{x}) = \mathrm{RMSNorm}(\bm{x} - \mu \bm{1})
\end{align}$$
因此,RMSNorm 可以看作 LayerNorm 的“无投影”版本。
7. 高维空间中向量天然与 1 正交
为什么去掉投影步骤是安全的?答案隐藏在高维空间的统计与几何特性中。
7.1 统计视角:余弦相似度 ~ $1/\sqrt{d}$
假设隐藏向量各维度独立且均值为零,则 $\bm{x}$ 与 $\bm{1}$ 的点积为 $\displaystyle \sum x_i$,其标准差为 $\sqrt{d}$,而 $|x|$ 的数量级也是 $\sqrt{d}$ 。二者余弦相似度为:
$$\begin{align}
\cos(\theta) = \frac{\sum x_i}{|x| \cdot |1|} \propto \frac{1}{\sqrt{d}}
\end{align}$$
当 $d=4096 $时,波动范围仅约 $ \pm1/64$,即向量与 $1$ 的夹角死死锁定在 $90°\pm 1°$附近;即使 d=768,波动也不过 $\pm1/28$。维度越高,正交锁定越强。
7.2 几何视角:测度集中
在高维单位球面上,绝大部分面积集中在“赤道”区域。对于任何给定向量如 $\bm{1}$,随机向量几乎必然落在其正交补空间附近。换句话说,正交是高维空间的常态而非特例。
7.3 网络动态视角
- 初始化:权重通常从零均值分布采样,初始隐藏状态天然满足 $\mu \approx 0$。
- 信息最大化:若隐藏向量的均值显著偏离零,意味着各维度共涨共跌,浪费了表达能力。网络在训练中会自发去相关,促使均值趋于零。
- 归一化层本身的强制:即使使用 LayerNorm,每次前向都会强制减均值,阻止了均值分量的累积。换成 RMSNorm 后,残差连接与权重衰减同样能约束幅度漂移。
实证测量发现,无论是在 LayerNorm 还是 RMSNorm 的 LLM 中,每一层隐藏向量与 $\bm{1}$的夹角始终保持在 87°~93° 之间,均值减法的实际效果微乎其微。
个人评述:在高维表示空间中,减均值如同打扫一间没有灰尘的房间,RMSNorm 果断砍掉了这个无用的步骤。
8. 小模型维度同样适用吗?
一个常见疑问是:当隐藏维度较小(如 $d=768$)时,“天然正交”的约束力是否会减弱到影响性能?
- 数学上,d=768 时余弦相似度波动约是 d=4096 的 2.5 倍,但仍处于很小的量级,均值依然大概率在零附近。
- 实证上,当前开源社区的大量小模型(TinyLlama、Qwen-0.5B、Phi-1.5 等)均已采用 RMSNorm,性能与 LayerNorm 基本无差。
- 性价比权衡:在小模型上,显存与计算资源更为紧张,RMSNorm 省下的归约操作和中间缓存的收益更为显著。减均值那一点微弱理论增益,远不及算力节省来得实在。
唯一的潜在风险在于极浅网络(如 2~4 层)中,若输入先验分布极不均匀,可能会产生暂时的均值漂移。此时需要更精细的初始化或适当增大 ε 来保证训练平稳,但这种情况较为罕见。
9. 总结与实践建议
RMSNorm 的流行并非偶然,它用“约分”般的简洁设计,实现了对 LayerNorm 的高效超越:
- 数学上:具备重缩放不变性和隐式学习率适应,训练更鲁棒;
- 几何上:与 LayerNorm 仅差一个沿 1 的投影,而该投影在高维空间中天然冗余;
- 工程上:省时、省显存、实现简单,加速效果随模型深度和规模递增。
实践建议:
- 新模型设计时直接选用 RMSNorm,无需保留 β 参数。
- ε 可设为 1e-5 或 1e-6,与 LayerNorm 实践一致。
- 如果模型极浅且出现训练初期 loss 震荡,可适当增大 ε 或微调学习率。
- 高效实现应复用前向计算中的 r 与归一化结果,避免重复求平方和。
最终评述:RMSNorm 是大模型时代“奥卡姆剃刀”精神的典范——删除多余的操作,反而释放出更强的训练效率与稳定性。理解其背后的数学,不仅能更好地使用它,也能启发我们以更本质的视角审视深度学习中的每一个组件。
参考文献
[^1]: Zhang, B., & Sennrich, R. (2019). Root mean square layer normalization. In Advances in Neural Information Processing Systems (Vol. 32). Curran Associates, Inc. https://doi.org/10.48550/arXiv.1910.07467
[^2]: Gupta, A., Ozdemir, A., Gong, C., & Anumanchipalli, G. (2024, September 19). Geometric interpretation of layer normalization and a comparative analysis with RMSNorm. arXiv. https://doi.org/10.48550/arXiv.2409.12951
| 版权声明 |  |
 | 由引线小白创作并维护的柠檬CC博客采用署名-非商业-禁止演绎4.0国际许可证。 本文首发于柠檬CC [ https://www.limoncc.com ] , 版权所有、侵权必究。 |
| 本文永久链接 | https://www.limoncc.com/post/459cffa89d9d94ff/ |
| 如果您需要引用本文,请参考: |
| 引线小白. (May. 18, 2026). 《大语言模型研究12——均方根层归一化(RMSNorm)》[Blog post]. Retrieved from https://www.limoncc.com/post/459cffa89d9d94ff |
| @online{limoncc-459cffa89d9d94ff, title={大语言模型研究12——均方根层归一化(RMSNorm)}, author={引线小白}, year={2026}, month={May}, date={18}, url={\url{https://www.limoncc.com/post/459cffa89d9d94ff}}, } |