作者: 引线小白-本文永久链接:https://www.limoncc.com/post/f8b4cf8901e0b294/
知识共享许可协议: 本博客采用署名-非商业-禁止演绎4.0国际许可证
一、引理
1.1、核心问题
核心问题是防溢出下如何分块递归求 softmax,其核心用数学表示就是:
$$\begin{align}
s=\sum_{i}\mathrm{e}^{x_i-\max[\bm{x}] }=s_K
\end{align}$$
能求得 $s_k$ ,然后通过 $s_1\to\cdots \to s_k\to \cdots \to s_K$ , 递归求得 $s$ 。
如果 $\bm{x}$ 占用显存超过了SRAM,溢出到HBM。那么用分块 $\bm{x}_k$,来递归计算 $s_k$ 是比总体计算快的选择,因为HBM到SRAM的数据传输延迟远高于计算延迟,因此减少数据传输次数是优化的关键。而限制在SRAM中做计算则没有这个问题。
求softmax, 最大的计算量在分母,如果不考虑溢出, 计算 $\sum_i \mathrm{e}^{x_i}$ 是完全可以分块计算的。只要不超过SRAM大小,一样加速。要考虑溢出问题,事情就麻烦了,因为传统的防溢出Softmax计算是一个两遍扫描的过程:
第一遍:遍历整个 $\bm{x}$ 求出全局最大值 $m = \max[\bm{x}]$ ;
第二遍:再次遍历 $\bm{x}$,计算 $s = \sum_i \mathrm{e}^{x_i - m}$,最后求 $\displaystyle \frac{\mathrm{e}^{x_i-m}}{s}$ 。
证明:
在分块计算的场景下,当我们在处理第 k 块 $\bm{x}_k$ 时,全局最大值 $m$ 是未知的,因此你无法在当前块直接算出真正的 $s_k$ 。为了解决这个问题,核心思想是:用局部最大值计算局部求和,并通过维护一个“运行最大值”来动态修正之前的求和结果。
$$\begin{align}
&m_k=\max_{i\in [1, k]}(\max[\bm{x}_i])\\
&s_k=\sum_{i\in [1, k]}\sum_{j\in \bm{x}_i}\mathrm{e}^{x_j-m_k}
\end{align}$$
假设我们将 $\bm{x}$ 分成 K 个块,定义到第 k 块为止的局部最大值为 $m_k$ ,局部指数和为 $s_k$ ,当我们从第k-1块推进到第k块时,局部最大值发生了更新
$$\begin{align}
\displaystyle m_k=\max(m_{k-1},m^*_k)
\end{align}$$
其中 $\displaystyle m^*_k=\max[\bm{x}_k]$ 是当前块的局部最大值。由于减去的最大值变大了 $\displaystyle m_k\geqslant m_{k-1}$ ,之前累加的 $s_k$ 整体缩小了。缩小的倍数正是 $\displaystyle \mathrm{e}^{m_{k-1} - m_k}$ 。于是我们可以得到如下的递推公式:
也就是有
$$\begin{align}
s_k=\mathrm{e}^{m_{k-1}-m_k}s_{k-1}+b_k
\end{align}$$
其中,$m_k=\max_{i\in [1, k]} (\max[\bm{x}_i])$, $b_k = \sum_{j \in \bm{x}_k} \mathrm{e}^{x_j - m_k}$ 是完全基于历史最大值和当前块内部最大值算出来的局部和,这可以在SRAM中直接防溢出计算。
1.2、硬件层面意义
这个递推公式 $s_k = \mathrm{e}^{m_{k-1} - m_k} s_{k-1} + b_k$ 完美契合了SRAM的限制:
分母的计算可以在单遍扫描内完成:我们不再需要先遍历一次HBM求全局最大值。只要从HBM按块加载 $\bm{x}_k$ 到SRAM,计算局部的 $m^*_k$ 和 $b_k$,然后与SRAM中寄存的标量 $m_{k-1}$ 和 $s_{k-1}$ 做一次O(1)的代数运算,即可更新为 $m_k$ 和 $s_k$。
无需回写HBM:中间过程的指数结果不需要写回HBM。SRAM中只需要常驻两个标量(累积最大值 $m_k$ 和累积和 $s_k$),极大幅度降低了显存占用(即 $O(N)$ 的中间向量 $\mathrm{e}^{x_i - m}$ 被消灭了,变成了 $O(1)$ 的标量存储开销)。
1.3、最后输出
对于纯向量 softmax, 必须两遍扫描,不存在单遍计算输出的捷径。这是输入输出维度决定的。
第一遍: 分块加载 $\bm{x}_k$,只为了更新两个标量 $m_k$ 和 $s_k$。处理完 $K$个块后,SRAM 里只留下了最终的全局 $m$ 和 $s$。
第二遍: 再次分块加载 $\bm{x}_k$,此时 $m$ 和 $s$ 已知,直接计算 $\frac{\mathrm{e}^{\bm{x}_k - m}}{s}$,算完一块就直接写回 HBM。SRAM 里根本不需要保留之前算过的 $o$。
在稍后的Attention块计算中,$\bm{O} = \mathrm{softmax}(\bm{Q}\bm{K}^T/\sqrt{d})\bm{V}$ 由于有了 $@\bm{V}$ 改变了输出维度,优化将更加友好。在纯向量softmax中,必须两遍扫描是因为第二遍要用全局的 $m$ 和 $s$ 重新算一遍归一化;但在Attention中,输出是 $\bm{o}_i = \sum_j \frac{\mathrm{e}^{S_{ij} - m_i}}{s_i} \bm{v}_j$ ,我们可以在SRAM内,一边更新 $s_i$,一边利用旧的 $s_{i}^{old}$ 修正之前累加的 $\bm{o}_i^{old}$ ,并加上新块的贡献。
二、递推公式的矩阵版本
上述引理我们仅讨论的对向量求softmax,但在Attention块,其实是对矩阵按行求softmax。所以现在我们来讨论矩阵版本的递推公式。定义第 $i$个查询块 $\bm{Q}_i\in \mathbb{R}^{r\times d}$, 同样定义第 $k$块键值:
$$\begin{align}
\bm{K}_k \in \mathbb{R}^{c\times d},\quad \bm{V}_k \in \mathbb{R}^{c\times d}
\end{align}$$
那么未放缩注意力分数矩阵
$$\begin{align}
\bm{H}_{ik} = \bm{Q}_i \bm{K}_k^\T \in \mathbb{R}^{r\times c}
\end{align}$$
需要的最终输出是
$$\begin{align}
\bm{O}_{i} = \mathrm{softmax}\bigg(\frac{\bm{Q}_i\bm{K}^\T}{\sqrt{d}}\bigg)\bm{V} \in \mathbb{R}^{r \times d}
\end{align}$$
为了在 SRAM 中分块完成,我们维护三组行级统计量(每行一个标量,整体是一个长度为 $r$的向量)
$\bm{m}_{ik}\in \mathbb{R}^{r}$: 到第 $k$块为止的行最大值
$\bm{s}_{ik}\in \mathbb{R}^{r}$: 到第 $k$块为止的行指数和
$\bm{\tilde{O}}_{ik}\in \mathbb{R}^{r\times d}$: 到第 $k$块为止的未归一化输出
初始化 $\bm{m}_i = -\bm{\infty}$, $\bm{s}_i = \bm{0}$, $\bm{O}_i = \bm{0}$,处理第 $k$个键值块时的向量化递推。这有:
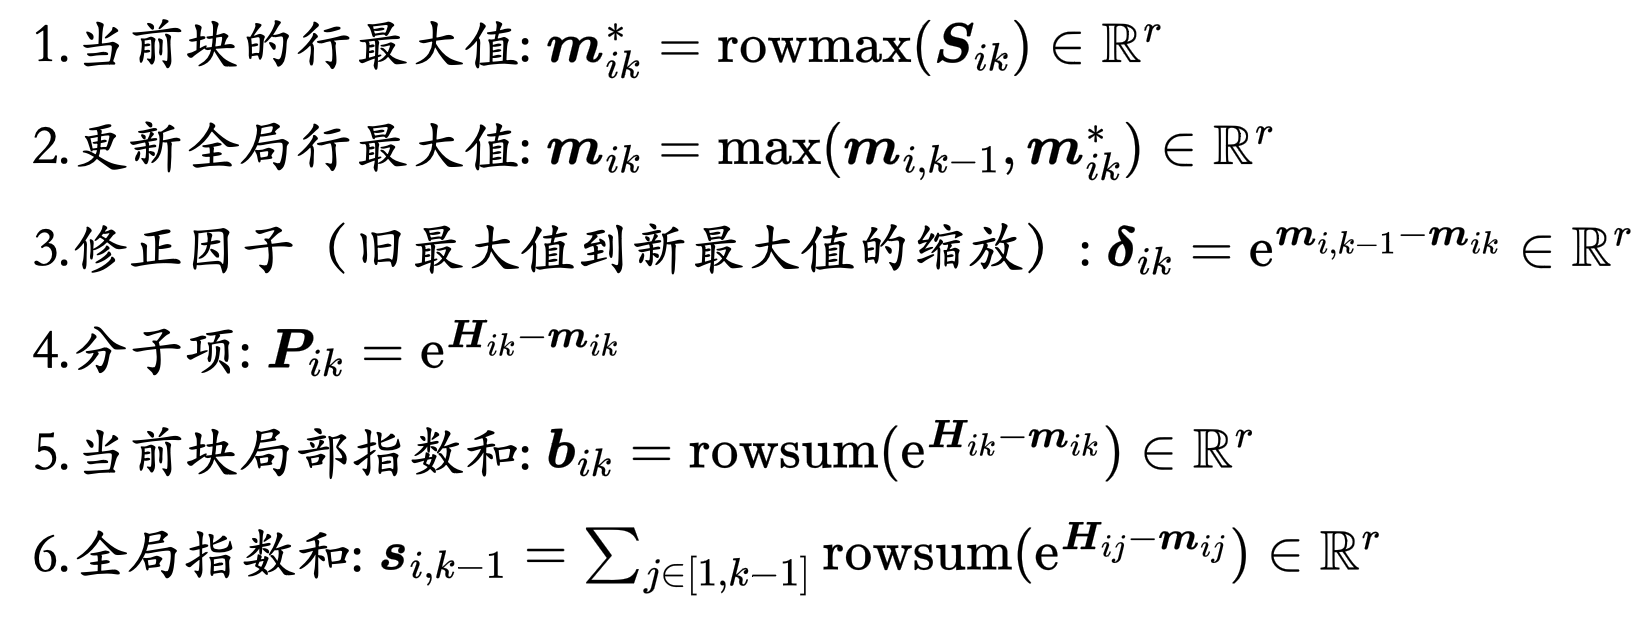
更新全局指数和:
$$\begin{align}
\bm{s}_{ik}
=\mathrm{e}^{\bm{m}_{i,k-1}-\bm{m}_{ik} }\odot \bm{s}_{i,k-1} + \bm{b}_{ik}
= \bm{\delta}_{ik}\odot \bm{s}_{i,k-1} + \bm{b}_{ik} \in \mathbb{R}^{r}
\end{align}$$
当前块未归一化输出: $\bm{\tilde{O}}_{ik}=\mathrm{e}^{\bm{H}_{ik}-\bm{m}_{ik}}\bm{V}_k \in \mathbb{R}^{r\times d}$
全局未归一化输出:
$$\begin{align}
\bm{O}_{ik}=\mathrm{diag}(\bm{\delta}_{ik})\bm{O}_{i,k-1}+\bm{\tilde{O}}_{ik} \in \mathbb{R}^{r\times d}
\end{align}$$
最终输出只需一次行归一化:
$$\begin{align}
\bm{O}_i = \bm{O}_{iK} =\mathrm{diag}^{-1}(\bm{s}_{iK}) \bm{\tilde{O}}_{iK}
\end{align}$$
三、FlashAttention的内外循环
上面讨论的是:在固定第 $i$个查询块 $\bm{Q}_i\in \mathbb{R}^{r\times d}$,如何求 $\bm{O}_i$, 实际上要求的是 $\bm{O}$, 这样有内外循环, 伪代码如下:
1 | # 初始化 HBM 中的最终输出矩阵 O,维度 N x d |
- 上标 $(k)$ 代表的是时间步(内层循环的进度),而不是空间上的行扩展。
- 在递推过程中,$\bm{O}_{ik}$ 始终对应同一个 Query 块 $\bm{Q}_i$,所以它的维度锁死在 $B_r \times d$。
- 完整的 $N \times d$ 输出,是靠外层循环不断将不同 Query 块算出的 $B_r \times d$ 拼接(写回 HBM 不同位置)而成的。
- 这种“外层按 $\bm{Q}$分块并行,内层按 $\bm{KV}$ 分块递推”的设计,正好完美匹配了 GPU 的架构:外层循环的不同 $i$ 可以分配给不同的 SM(流多处理器)完全并行计算,而内层循环则在 SRAM 中串行/流式处理,避免了对 HBM 的反复读写。
四、如何控制 Q和 KV的分块大小
分块大小不是由算法偏好决定的,而是被每个 SM(流式多处理器)SRAM 大小决定的。我们要确保一件事:在计算内循环 $\bm{Q}_i\bm{K}_k$时,所有需要的中间变量,必须完全塞进 SRAM 里,绝不能溢出到 HBM。我们以 A100 上常见的 FP16/BF16 (2 bytes/element) 精度,Head维度 $d = 128$ 为例,来算这笔账。
4.1、基础变量设定
- $B_r$: Q 的分块行数(块大小)
- $B_c$: KV 的分块行数(块大小)
- $d$: 注意力头维度 (128)
- 单个元素大小: 2 Bytes
4.2、盘点 SRAM占用时间线
在内循环的一次迭代中,SRAM 里必须有可能驻留以下数据:
- $\bm{Q}_{block}$:大小 $B_r \times d$ $\rightarrow$ 占用 $2 B_r d$ Bytes
- $\bm{K}_{block}$:大小 $B_c \times d$ $\rightarrow$ 占用 $2 B_c d$ Bytes
- $\bm{V}_{block}$:大小 $B_c \times d$ $\rightarrow$ 占用 $2 B_c d$ Bytes
- $\bm{H}_{block}$ (中间得分矩阵):这是罪魁祸首! $\bm{Q}_{block} \times \bm{K}_{block}^\T$ 会产生一个 $B_r \times B_c$ 的矩阵 $\rightarrow$ 占用 $2 B_r B_c$ Bytes
- $\bm{P}_{block}$ (分子项目): 大小 $B_r \times B_c$ $\rightarrow$ 占用 $2 B_r B_c$ Bytes
- $\bm{O}_{block}$ (累积输出):大小 $B_r \times d$ $\rightarrow$ 占用 $2 B_r d$ Bytes
- $\bm{m}_{old},\bm{m}_{new}$ (统计量需要用FP32):大小 $2*times B_r$ $\rightarrow$ 占用 $8B_r $ Bytes
- $\bm{s}_{old},\bm{s}_{new}$ (统计量需要用FP32):大小 $2*times B_r$ $\rightarrow$ 占用 $8B_r $ Bytes
- $\bm{\delta}$ (统计量需要用FP32):大小 $B_r$ $\rightarrow$ 占用 $4B_r $ Bytes
总 SRAM 占用估算:
实际SRAM占用是随着时间线动态变化的,来看看FlashAttention-1的显存分析
1、加载Q_block $\rightarrow$ $2B_rd$ Bytes
2、初始化m_old、s_old 、O_old $\rightarrow$ $\underbrace{2B_rd}_{\small \text{加载Q_block}} +
\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}}$ Bytes
3、加载KV_block $\rightarrow$ $\underbrace{2B_rd}_{\small \text{加载Q_block}}+
\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载K_block}} +
\underbrace{2B_cd}_{\small \text{加载V_block}}$ Bytes
3、计算未放缩注意力分数S_block $\rightarrow$ $\underbrace{2B_rd}_{\small \text{加载Q_block}}+
\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载K_block}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{2B_rB_c}_{\small \text{未放缩注意力分数S_block}}$ Bytes
4、更新行最大值m_new $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{2B_rB_c}_{\small \text{未放缩注意力分数S_block}} +
\underbrace{4B_r}_{\small \text{更新m_new}}$ Bytes
5、计算修正因子delta $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{2B_rB_c}_{\small \text{未放缩注意力分数S_block}} +
\underbrace{4B_r}_{\small \text{更新m_new}} +
\underbrace{4B_r}_{\small \text{修正因子delta}}$ Bytes
6、更新统计量m $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{2B_rB_c}_{\small \text{未放缩注意力分数S_block}} +
\underbrace{4B_r}_{\small \text{修正因子delta}}$ Bytes
6、分子项目P_block $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{2B_rB_c}_{\small \text{未放缩注意力分数S_block}} +
\underbrace{4B_r}_{\small \text{修正因子delta}} +
\underbrace{2 B_rB_c}_{\small \text{分子项目P_block}}$ Bytes
7、更新分母s_new $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{4B_r}_{\small \text{修正因子delta}} +
\underbrace{2B_rB_c}_{\small \text{分子项P_block}} +
\underbrace{8B_r}_{\small \text{更新分母s_new}}$ Bytes
8、更新统计量s $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{4B_r}_{\small \text{修正因子delta}} +
\underbrace{2B_rB_c}_{\small \text{分子项P_block}}$ Bytes
8、更新未归一O_back $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}} +
\underbrace{2B_cd}_{\small \text{加载V_block}} +
\underbrace{4B_r}_{\small \text{修正因子delta}} +
\underbrace{2B_rB_c}_{\small \text{分子项P_block}} +
\underbrace{2B_rd}_{\small \text{更新未归一O_back}}$ Bytes
10、计算最终O $\rightarrow$ $\underbrace{4B_r+ 4B_r+2B_rd}_{\small\text{初始化m,s,O}}
+\underbrace{2B_rd}_{\small\text{更新未归一O}}+
\underbrace{2B_rd}_{\small \text{归一O}}$ Bytes
11、终止 $\rightarrow$ $\underbrace{4B_r+ 4B_r + 2B_rd}_{\small \text{初始化m,s,O}}$ Bytes
4.3、FlashAttention-2的极致优化
在写底层算子时,变量不是像 PyTorch 那样同时静态存在的,而是“流”过 SRAM 的。寻找整个时间线上的峰值,才是决定 Block Size 能设多大的唯一判据。按照 FA2 的极致优化,这条时间线还可以被压缩。下面重新走一遍这条时间线:
4.3.1、三个颠覆性的优化前提
在重写时间线之前,必须确立 FA2 的三大原则,这将大幅削减你的内存占用:
- 1、干掉中间变量P_block:正如上一轮讨论,$\exp(S - m)$ 的计算直接融合进 @ V_k 里,$2 B_r B_c$ 的 P_block彻底消失。
- 2、K/V 内存复用:K_block和 V_block大小完全一样($B_c \times d$),且在内循环中是串行使用的(先算 $QK^T$,再算 $PV$)。所以,它们共享同一块 SRAM 空间,算完 K 立刻覆盖写入 V,省掉一半占用。
- 3、统计量寄存器化:$m_{old/new}, s_{old/new}, \delta$ 以及 $\tilde{O}$,在 FA2 中根本需要在 SRAM 里!它们被分配给了每个线程独占的寄存器。所以下面 SRAM 的账本里,不再计算它们的占用。
4.3.2、FA2 极致时间线
假设我们分配了一块名为 KV_BUFFER 的 SRAM 空间(大小 $2 B_c d$),一块 Q_BUFFER(大小 $2 B_r d$)。
1、外循环伊始(加载 Q)
- 动作:将 $Q_{block}$从 HBM搬入 Q_BUFFER。初始化寄存器里的 $m, s, \tilde{O}$。
- SRAM峰值:$\underbrace{2B_rd}_{\text{Q_BUFFER}}$
2、内循环第 k 步:加载 K
- 动作:将 $K_{block}$ 搬入 KV_BUFFER。
- SRAM峰值:$\underbrace{2B_rd}_{\text{Q_BUFFER}} + \underbrace{2B_cd}_{\text{KV_BUFFER (存K)}}$
3、计算 $H = QK^T$
- 动作:矩阵乘法,结果 $H_{block}$ 逐元素生成。注意:为了省空间,$H_{block}$ 甚至不配拥有完整的 SRAM 缓冲区! 它是一小块一小块(比如 16x16)在寄存器里算出来,马上进入下一步。
- SRAM峰值:不变。
4、融合计算:$m_{new}$, $\delta$, $\exp$, 修正 $\tilde{O}$,更新 $s$
- 动作:这是计算最密集的一步。在寄存器里算出 $m_{new}$ 和 $\delta$。此时 $K_{block}$ 已经没用了!
- SRAM峰值:不变。
5、加载V,覆盖K
- 动作:将 $V_{block}$ 从 HBM 搬入 KV_BUFFER,直接覆盖掉刚才的 $K_{block}$。
- SRAM峰值:$\underbrace{2 B_r d}_{\text{Q_BUFFER}} + \underbrace{2 B_c d}_{\text{KV_BUFFER (存V)}}$
6、融合计算:$\exp(S) \times V$ 累加到 $\tilde{O}$
- 动作:把刚才寄存器里的 $\exp(S)$ 逐行拿出来,跟 KV_BUFFER里的 $V$ 相乘,结果累加到寄存器的 $\tilde{O}$ 中。
- SRAM峰值:不变。
7、内循环终点
- 动作:当前 KV 块处理完毕,准备进入第 k+1 块。
- SRAM峰值:$\underbrace{2 B_r d}_{\text{Q_BUFFER}} + \underbrace{2 B_c d}_{\text{KV_BUFFER}}$ (准备被下一个 K 覆盖)
4.3.3、终极账本:SRAM 到底需要多大?
看完了整条时间线,会发现 SRAM 的峰值占用极其平稳,没有任何波峰:
$$\begin{align}
\text{SRAM}_{\text{peak}} = 2B_rd + 2B_cd
\end{align}$$
这就是全部!没有 $B_rB_c$ 的中间矩阵,没有 $m, s, O$ 的占用。再拿 A100 (可用 SRAM ~100 KB, $d=128$, FP16) 算算看:
$$\begin{align}
&(2 B_r \times 128 + 2 B_c \times 128) \times 2 \le 102400\\
&512 B_r + 512 B_c \le 102400
\end{align}$$
如果取对称分块 $B_r = B_c$:
$$\begin{align}
1024 B_r \le 102400 \implies B_r \le 100
\end{align}$$
现在,通过消灭P、K/V复用、统计量寄存器化这三板斧,大大提高了$B_r$ 的理论上限 考虑到 Tensor Core对齐(必须是 8/16/32/64/128 的倍数),FlashAttention-2 才敢肆无忌惮地把 $B_r$ 和 $B_c$ 设到 64 或 128,从而把 HBM 的 IO 次数压到最低,跑出理论极限带宽。
五、个人评述
底层优化的本质,就是在这条时间线上玩俄罗斯方块:不仅要消除 $P_{block}$ 这种多余的方块,还要让 $K$ 和 $V$ 这种形状相同的方块完美重叠(内存复用),最后把 $m, s, O$ 这种零碎的方块塞进寄存器的缝隙里。这样,SRAM 这个狭小的舞台,才能跳出最快速的舞蹈。
参考文献
[^1]:Dao, T., Fu, D. Y., Ermon, S., Rudra, A., & Ré, C. (2022, May 29). FlashAttention: Fast and memory-efficient exact attention with IO-awareness. arXiv. https://doi.org/10.48550/arXiv.2205.14135
[^2]:Dao, T. (2023, July 17). FlashAttention-2: Faster attention with better parallelism and work partitioning. arXiv. https://doi.org/10.48550/arXiv.2307.08691
[^3]:Shah, J., Bikshandi, G., Zhang, Y., Thakkar, V., Ramani, P., & Dao, T. (2024, July 11). FlashAttention-3: Fast and accurate attention with asynchrony and low-precision. arXiv. https://doi.org/10.48550/arXiv.2407.08608
| 版权声明 |  |
 | 由引线小白创作并维护的柠檬CC博客采用署名-非商业-禁止演绎4.0国际许可证。 本文首发于柠檬CC [ https://www.limoncc.com ] , 版权所有、侵权必究。 |
| 本文永久链接 | https://www.limoncc.com/post/f8b4cf8901e0b294/ |
| 如果您需要引用本文,请参考: |
| 引线小白. (May. 19, 2026). 《大语言模型研究14——注意力机制优化之FlashAttention》[Blog post]. Retrieved from https://www.limoncc.com/post/f8b4cf8901e0b294 |
| @online{limoncc-f8b4cf8901e0b294, title={大语言模型研究14——注意力机制优化之FlashAttention}, author={引线小白}, year={2026}, month={May}, date={19}, url={\url{https://www.limoncc.com/post/f8b4cf8901e0b294}}, } |